

O que você vai aprender aqui
- Por que a headline e as top 5 skills determinam em qual cluster semântico o algoritmo te encaixa
- Como o modelo 360Brew lê seu perfil como texto, e o que isso muda na prática
- As quatro seções que mais impactam o alcance orgânico
- Por que saves valem mais do que curtidas, com base na arquitetura do sistema
- Como o LinkedIn decide distribuir conteúdo para pessoas fora da sua rede
Entrei no LinkedIn em abril de 2004. Ao longo de 22 anos, precisei otimizar o perfil do LinkedIn várias vezes acompanhando mudanças de carreira: comecei como gerente de sistemas, migrei para empreendedor, e nos últimos anos concentrei o foco em educação executiva em IA e dados. Cada transição exigiu reconfigurar a sinalização do perfil do zero.
Ao longo desse tempo, circulou muito “como o LinkedIn funciona” baseado em experimentos com alguns posts e muita especulação. Quando surgiram rumores de um vazamento sobre o algoritmo do feed, pesquisei na origem e encontrei documentação técnica publicada pela própria equipe: um paper acadêmico e posts dos engenheiros responsáveis pelo sistema de ranking.
Este artigo é baseado nessa documentação: papers com medições reais sobre milhares de posts e Engineering Blog dos próprios autores do sistema.
Tenho e-books gratuitos sobre tecnologia, liderança e carreira. Se você quer aprofundar os fundamentos de IA aplicados ao trabalho, os materiais de lá são um bom ponto de partida.
O que o LinkedIn usa para decidir quem vê você
O LinkedIn opera, desde 2025, com um modelo chamado 360Brew, anunciado publicamente em março de 2026 no Engineering Blog da empresa. Ele tem 150 bilhões de parâmetros e substitui cerca de 30 modelos especializados que existiam antes. O paper técnico original está em arXiv 2501.16450v1 (posteriormente retirado do arXiv por questão de licença, mas o conteúdo técnico permanece válido).
A mudança mais importante: o 360Brew não usa IDs para identificar perfis e posts. Ele lê tudo como texto, incluindo sua headline, o About, as descrições de cargo e o histórico de posts. A partir desse texto, o modelo infere em qual cluster temático você pertence.
Se o seu perfil mistura temas sem coerência, o modelo não consegue te encaixar em nenhum cluster com precisão. Um perfil mal clusterizado recebe menos distribuição, mesmo que os posts sejam bons.
Há um paper anterior, o LiNR (arXiv 2407.13218, publicado no CIKM ’24 da ACM), que documenta como o sistema funcionava antes. Os princípios fundamentais continuam válidos no 360Brew, mas agora processados semanticamente, sem categorias fixas.
Como otimizar o perfil do LinkedIn: as quatro seções que determinam seu cluster
1. Headline
A headline é o campo de maior peso na clusterização. O LinkedIn a indexa com mais força que qualquer outra seção.
Você tem 220 caracteres. Use dois ou três termos que descrevem exatamente o que você faz, sem decoração. Meu perfil tem as duas versões de idioma. O exemplo abaixo é a versão em português do meu perfil atual (aprovada em maio/2026):
“Palestrante e Instrutor Corporativo em IA, Dados & Inovação | Professor ESPM, Insper, USP, PUCRS & IBGC | Autor: Engenharia de Prompts na Prática | Desde 1990”
Cada elemento serve a uma função: o cluster principal está em “IA, Dados & Inovação”, as credenciais institucionais estão explícitas, o livro ancora autoridade e “Desde 1990” ancora experiência.
O que eliminar: cargos genéricos como “Executivo” ou “Líder”, adjetivos vazios como “apaixonado por” ou “especialista em soluções”, e títulos que não dizem o que você entrega.
2. About
O About é onde o modelo mede a densidade de vocabulário do seu cluster. Os termos principais precisam aparecer ao longo do texto para reforçar o sinal semântico. Repetição coerente de termos-chave amplifica a clusterização.
Escreva o About como texto descritivo, não como lista de habilidades. Apresente o que você faz, para quem, com o vocabulário do seu cluster. Inclua clientes ou instituições que ancorem credibilidade quando puder nomear.
Adicione a versão em português via “Adicionar idioma”. O LinkedIn serve a versão no idioma do visitante.
3. Top 5 Skills
As top 5 skills entram como feature explícita no modelo. O problema: o LinkedIn ordena as skills por endorsements, não por relevância atual. Uma skill antiga com muitas recomendações aparece no topo e dilui o cluster.
A correção é manual. Reordene no painel de Skills para que as cinco primeiras sejam do cluster atual. Para o cluster de IA e dados: Inteligência Artificial (IA), IA Generativa, Engenharia de Prompts, Treinamento Corporativo, Políticas e Governança de IA.
Esse ajuste costuma ter o maior impacto imediato, segundo o que o paper LiNR documenta sobre o peso das skills no modelo.
4. Descrições de cargo
A primeira frase de cada cargo atual tem o maior peso semântico. O modelo lê com mais atenção o início das descrições.
Reescreva as primeiras frases dos cargos ativos para abrirem com o substantivo do cluster. “Professor de Inteligência Artificial na ESPM” performa melhor que “Professor da pós-graduação da ESPM”. Para o modelo, essa diferença não é pequena.
Descrições com pelo menos três ou quatro linhas reforçam o cluster mais do que frases únicas.
Interest graph vs. social graph
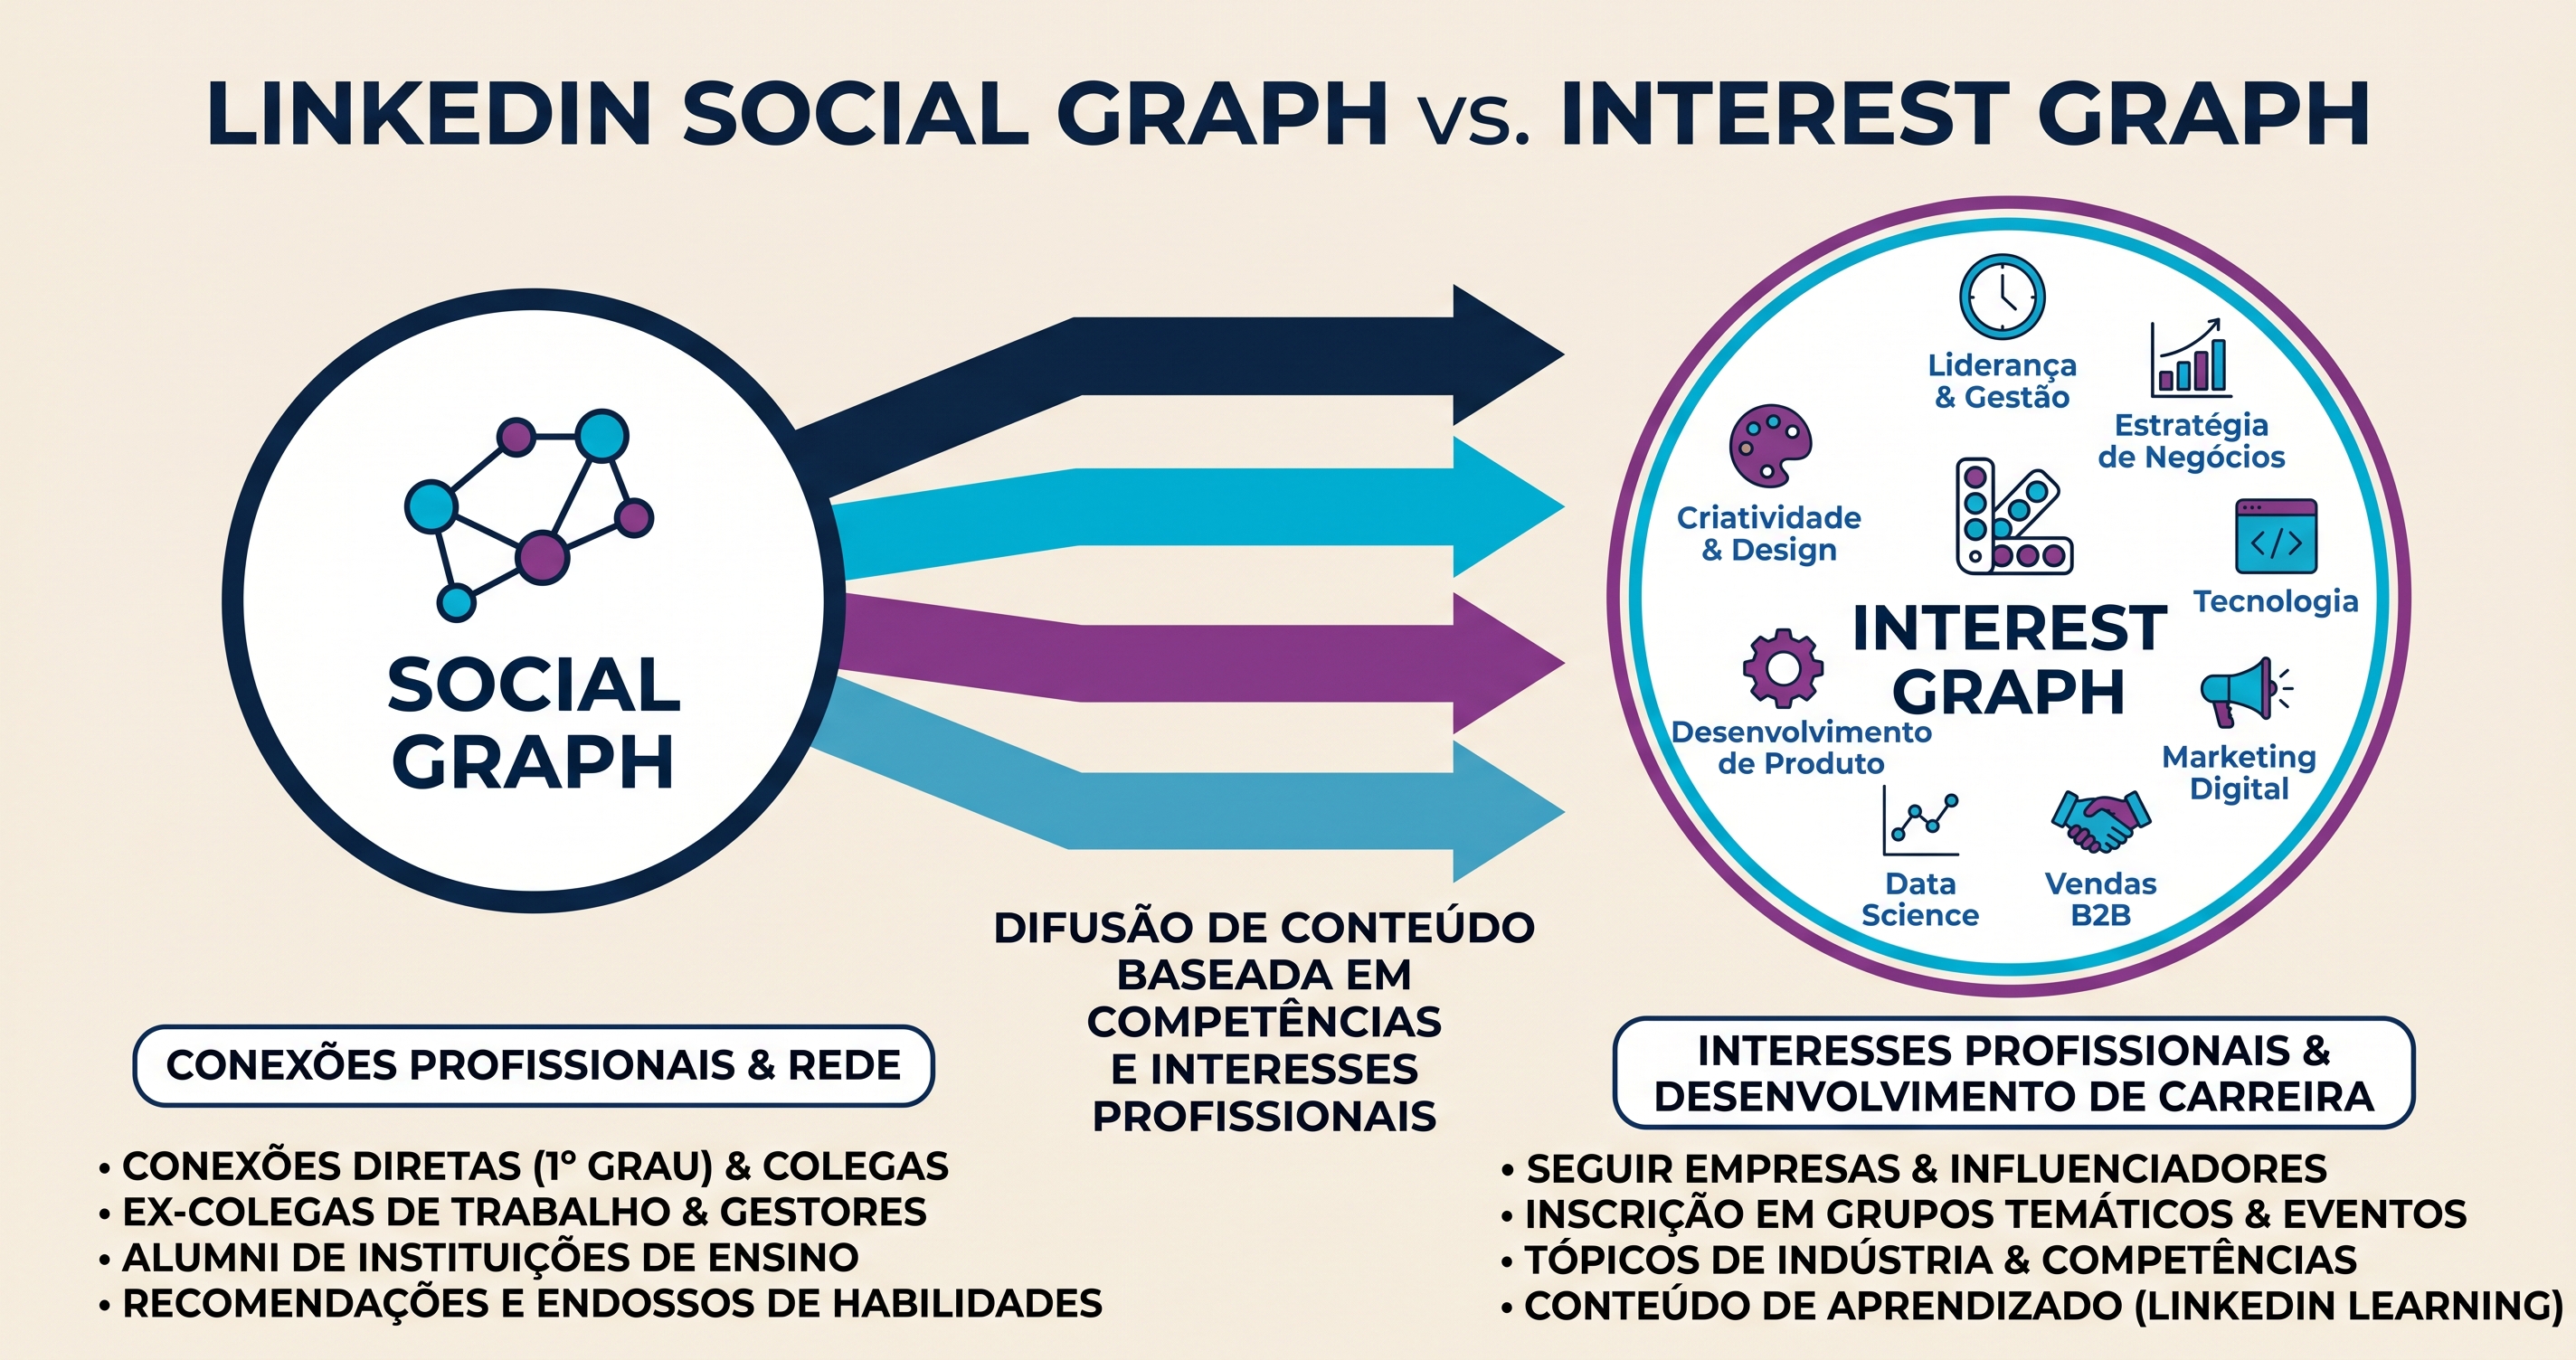
O sistema atual distribui conteúdo com base em interesse, não só em quem você segue. Um post seu pode chegar a pessoas que nunca ouviram falar de você, se o tema bater com o histórico de interesse delas.
Cluster tópico forte e vocabulário consistente são ainda mais importantes agora: são eles que determinam em quais “perfis de interesse” o seu conteúdo vai aparecer, além da sua rede direta.
Saves, comentários e qualidade de engajamento
Salvar um post implica intenção de revisitar. O modelo aprende que saves correlacionam com qualidade percebida e distribui mais conteúdo que recebe essa ação.
Inclua CTA de save com motivo concreto:
- Padrão fraco: “Salve se curtiu.”
- Padrão eficaz: “Salve para consultar quando for montar seu próximo treinamento.”
O 360Brew também lê o texto das interações. Comentários genéricos como “ótimo post” têm sinal mais fraco do que comentários que referenciam o conteúdo. CTAs que geram respostas com substância valem mais do que CTAs que pedem reação simples.
Dwell time: o sinal que mais importa
Dwell time é o tempo que o leitor passa com o post visível na tela. O LinkedIn usa esse sinal desde pelo menos 2020: posts que desaparecem da tela em poucos segundos sem nenhuma ação são classificados como “skipped” (ignorados) e têm distribuição reduzida. Posts que prendem o leitor por mais tempo recebem distribuição ampliada.
Fonte: Understanding dwell time to improve LinkedIn feed ranking, LinkedIn Engineering Blog, mai/2020. Conceito confirmado no Engineering Blog de mar/2026.
Três ajustes que aumentam o dwell time:
Primeira frase como gancho. O leitor decide em dois ou três segundos se vai parar de rolar. A primeira frase precisa criar tensão, apresentar dado contraintuitivo ou abrir situação em que o leitor se reconhece. Abertura com explicação de conceito é o padrão que mais gera skip.
Formatos de leitura longa. Carrosséis e PDFs têm dwell time estruturalmente mais alto porque o leitor precisa de mais tempo para consumir o conteúdo. O Featured do perfil deveria ter pelo menos um item assim.
Coerência dos últimos 60-90 dias de posts. O modelo usa o histórico recente para definir o cluster temático percebido do autor. Posts fora do cluster diluem o sinal e prejudicam a distribuição dos próximos.
Featured e frequência de posts
O Featured é lido como sinal de prioridade editorial. Três ou quatro itens são suficientes, todos dentro do cluster. Priorize itens de alto dwell time como PDF ou carrossel. Destaques de outras épocas fora do cluster atual enviam sinal de dispersão temática.
Sobre frequência: uma vez por semana é o mínimo para manter o histórico de contexto ativo. Duas ou três publicações de qualidade por semana funcionam melhor do que publicar todo dia com conteúdo fraco. O sistema não premia volume.
O que o LinkedIn suprime
Em maio de 2026, Laura Lorenzetti, VP Global Editorial do LinkedIn, publicou um post anunciando que a plataforma limitaria a distribuição de conteúdo genérico gerado por IA. Em testes iniciais, o sistema identificou posts de baixa qualidade com 94% de precisão. A política não remove o conteúdo, mas restringe o alcance ao círculo de primeiro grau.
O diferencial para escapar desse filtro está na especificidade: dado de campo, experiência própria, ângulo que só você teria com sua trajetória. O sistema suprime conteúdo sem perspectiva autoral, independentemente de quem ou o quê o escreveu.
Consistência de entidade
O LinkedIn, o Google e os sistemas generativos como ChatGPT, Gemini, Claude e Perplexity resolvem autoridade por entidade textual. Se o seu nome aparece de formas diferentes em LinkedIn, site, mídia e currículos, o sinal de autoridade se fragmenta.
Padronize uma forma única. Verifique que LinkedIn, site e perfis institucionais usam exatamente a mesma forma. Se quiser entender como esses sistemas generativos indexam e citam perfis, o artigo sobre GEO e otimização para IAs aprofunda os mecanismos de visibilidade além do Google.
Onde começar amanhã
Quatro ações em ordem de execução:
- Reordene as top 5 skills para que as cinco primeiras sejam do cluster atual.
- Reescreva a primeira frase de cada cargo ativo para abrir com o substantivo do cluster.
- Revise o About para que os termos principais apareçam ao longo do texto de forma natural.
- Verifique o Featured: ao menos um item com alto dwell time.
A mesma lógica de sinalização semântica vale para outros documentos profissionais. O artigo sobre currículo para IA mostra como os três leitores do seu CV (parser ATS, scorer semântico e recrutador humano) avaliam coerência de cluster da mesma forma que o LinkedIn.
O perfil não é vitrine. É o insumo que o modelo usa para decidir onde distribuir o seu conteúdo.
Se você quer ir além da receita e entender o porquê, os cursos que curado na ESPM têm professores com atuação real no mercado. O Consultor de Carreira indica qual faz mais sentido para o seu perfil.
Perguntas frequentes
Por que meus posts chegam só para quem já me segue? O cluster tópico do seu perfil está provavelmente disperso, ou o histórico de posts recentes é incoerente. O 360Brew distribui para fora da sua rede via interest graph, mas só quando o cluster semântico está claro o suficiente para o modelo saber em quais perfis de interesse encaixar o seu conteúdo.
Devo postar em inglês ou português? Depende da audiência prioritária. Para clientes brasileiros, português gera mais engajamento. Para alcance internacional, inglês abre mais oportunidades de distribuição via interest graph. A headline fica em um idioma só. O About pode ter as duas versões via “Adicionar idioma”.
Quantas vezes por semana devo postar? Uma vez é o mínimo para manter o histórico de contexto ativo para o modelo. Duas ou três vezes com qualidade performa melhor do que publicar todo dia com conteúdo fraco.
Skills com muitas recomendações fora do cluster fazem mal? Não necessariamente fazem mal, mas ocupam espaço nas top 5 e enviam sinal errado. A solução não é deletar, é reordenar manualmente para que as cinco primeiras sejam do cluster atual.
O LinkedIn detecta se usei IA para escrever? O que o LinkedIn suprime não é o uso de IA, é conteúdo sem perspectiva autoral. Em testes iniciais, o sistema identificou posts genéricos com 94% de precisão. Um post escrito com IA que carrega experiência real e ângulo único passa no filtro. Um post genérico escrito por humano também pode ser suprimido.
Como saber se meu perfil está bem clusterizado? Leia o texto do perfil e tente identificar o tema dominante em uma frase. Se você não conseguir, o modelo também não consegue. O cluster deve ser evidente nos três primeiros campos: headline, About e top 5 skills.
Featured ajuda no alcance dos posts? Indiretamente. Itens de alto dwell time como PDF ou carrossel reforçam a percepção de qualidade do perfil. Não há documentação direta de que o Featured influencia a distribuição dos posts, mas compõe o sinal geral de qualidade do perfil.
Edney “InterNey” Souza trabalha com tecnologia desde 1990. Está no LinkedIn desde abril de 2004, onde passou por três fases distintas da carreira: gerente de sistemas, empreendedor e, nos últimos anos, professor, palestrante e conselheiro consultivo em IA, dados e inovação. Participou da criação de sete startups. Leciona na ESPM, Insper, USP, PUCRS e IBGC. É autor de “Engenharia de Prompts na Prática”, best seller na Amazon e disponível gratuitamente em interney.net/livro-ia. Também é autor de vários e-books gratuitos sobre tecnologia, marketing, liderança e inovação, disponíveis aqui.
